Se abre en una pestaña nueva
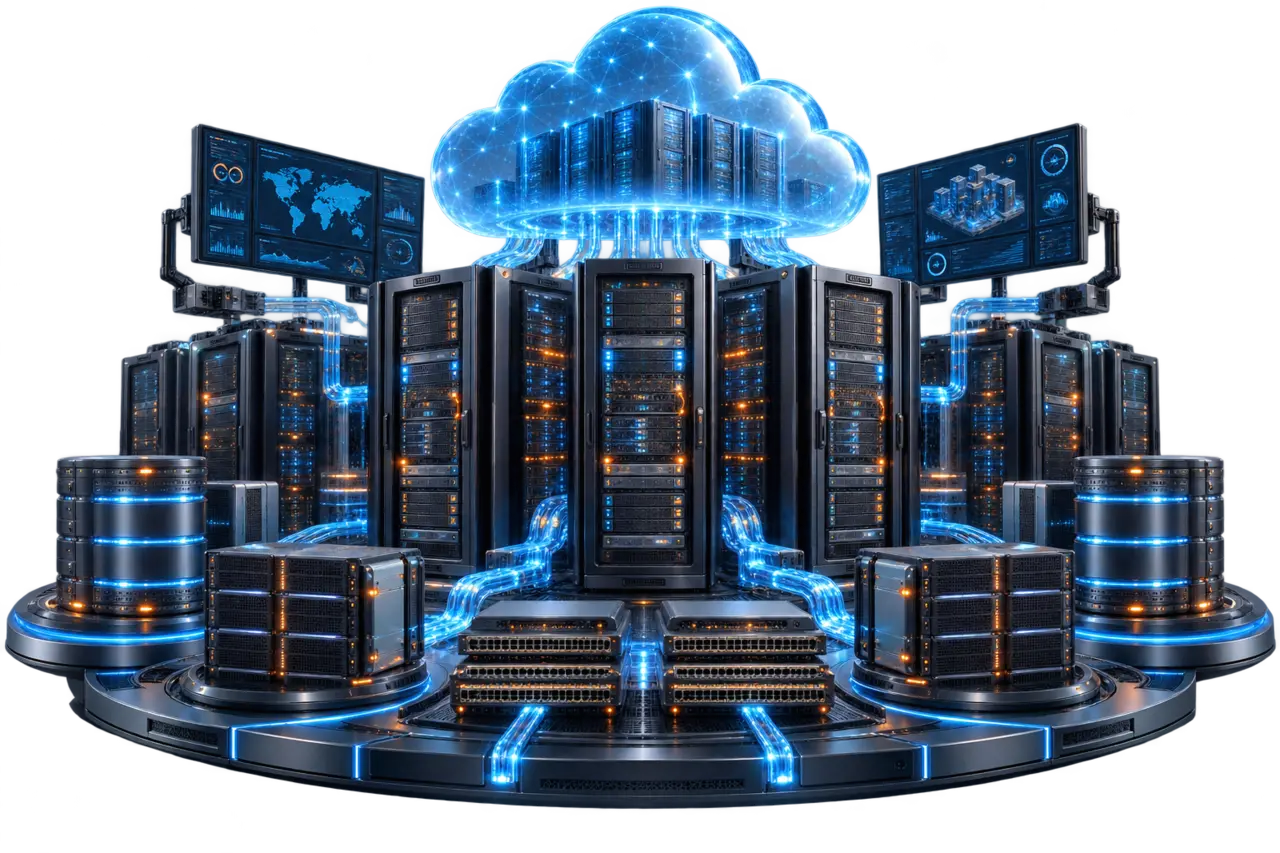
Ilustración profesional sobre cómo evitar caídas y pérdida de datos

Inicio/Problemas/¿Cómo evitar caídas y pérdida de datos?

Tecnología y sistemas

¿Cómo evitar caídas y pérdida de datos?

La actividad depende de sistemas cuya recuperación nunca se ha probado.

Nuestro criterio. Clasificar servicios críticos, definir RTO y RPO, aplicar copias aisladas, monitorización, redundancia proporcionada y simulacros.

Diagnóstico

¿Es momento de actuar?

La actividad depende de sistemas cuya recuperación nunca se ha probado. Hay que identificar sistemas críticos, comprobar el estado de las copias y realizar restauraciones que permitan contrastar los objetivos RTO y RPO.

Tecnología útil. Riesgo controlado.

Señales que puedes observar
✓

Incidencias recurrentes

El mismo fallo o limitación vuelve a afectar a la actividad.
✓

Coste creciente

Mantener la situación exige más recursos sin mejorar el resultado.
✓

Sistemas desconectados

Herramientas e infraestructuras no comparten contexto suficiente.
✓

Recuperación incierta

No está probado cómo responder y continuar ante un fallo.
△

Conclusión

Si nunca has restaurado una copia o desconoces cuánto tiempo puede permanecer parado un sistema crítico, debes evaluar la continuidad operativa.
Impacto en tu negocio

Lo que está en juego

Cuando la base tecnológica falla, el efecto se traslada a personas, clientes y continuidad del negocio.
◷

Tiempo

Más tiempo dedicado a compensar la situación descrita y menos a tareas de valor.
La carga se reparte y puede pasar desapercibida.
◎

Fiabilidad

Mayor probabilidad de errores, retrasos o decisiones inconsistentes.
La calidad del resultado depende de controles manuales.
▥

Control

Menor capacidad para crecer, responder y aprender con datos fiables.
El problema se amplifica cuando aumenta el volumen.
El origen del problema

No es un hecho aislado: es un problema de organización

La actividad depende de sistemas cuya recuperación nunca se ha probado. El riesgo aumenta cuando aplicaciones, servidores y proveedores carecen de redundancia proporcionada, supervisión y responsables de recuperación definidos.
⌘

Arquitectura

La solución ha crecido sin un diseño común y actualizado.
◉

Capacidad

Recursos, costes y necesidades reales no se revisan juntos.
♧

Seguridad

Accesos, exposición y continuidad se gestionan por separado.
▣

Gobierno

Faltan responsables, métricas y criterios de evolución.
Cómo avanzar

Un camino claro hacia el cambio

01

Diagnosticar

Confirmar el alcance, las personas afectadas, los puntos de fallo y las evidencias disponibles.
02

Priorizar

Ordenar las acciones por impacto, urgencia, dependencia y esfuerzo antes de elegir tecnología.
03

Resolver por fases

Clasificar servicios críticos, definir RTO y RPO, aplicar copias aisladas, monitorización, redundancia proporcionada y simulacros.
Qué puede resolverlo

Soluciones y servicios relacionados

Conectamos este problema con la solución y los servicios que pueden abordarlo de forma práctica.
Infraestructura cloud con copias restaurables, monitorización y continuidad operativa
Solución principal

Cloud, sistemas y continuidad con recuperación probada

Diseñamos infraestructura observable, copias restaurables y capacidad suficiente para que una incidencia no se convierta en una parada prolongada.
Saber más →
Ilustración de copias seguridad continuidad negocio
Servicio

Copias de seguridad y continuidad de negocio

Diseñamos continuidad de negocio con copias aisladas, restauraciones probadas y prioridades acordadas.
Saber más →
Ilustración de cloud servidores gestionados
Servicio

Cloud y servidores gestionados

Diseñamos y administramos infraestructura cloud, servidores y virtualización con capacidad, seguridad y coste visibles.
Saber más →
Resultados esperados

Qué debe cambiar para considerar que ha funcionado

La mejora debe comprobarse en la forma de trabajar, en la calidad de la información y en la capacidad para tomar decisiones.

Antes

× La actividad depende de sistemas cuya recuperación nunca se ha probado.
× Trabajo adicional para compensar fallos y excepciones
× Información o criterios difíciles de verificar
× Dependencia de personas, canales o herramientas aisladas

Después

✓ Clasificar servicios críticos, definir RTO y RPO, aplicar copias aisladas, monitorización, redundancia proporcionada y simulacros.
✓ Proceso más claro, medible y compartido
✓ Información verificable para decidir y actuar
✓ Más autonomía, continuidad y capacidad de evolución
Preguntas frecuentes

Dudas comunes

Respuestas directas para valorar el alcance y el siguiente paso.
Hablemos de tu caso

Cada negocio es único. Hablemos del tuyo.

Cuéntanos qué sistemas no pueden detenerse y cuándo se probó su recuperación. Revisaremos prioridades de continuidad.
Revisar mi situación →
Menos dudas. Más control. Un mismo equipo.